Jev: открытый клон дал 90% против 93% — AI-дайджест
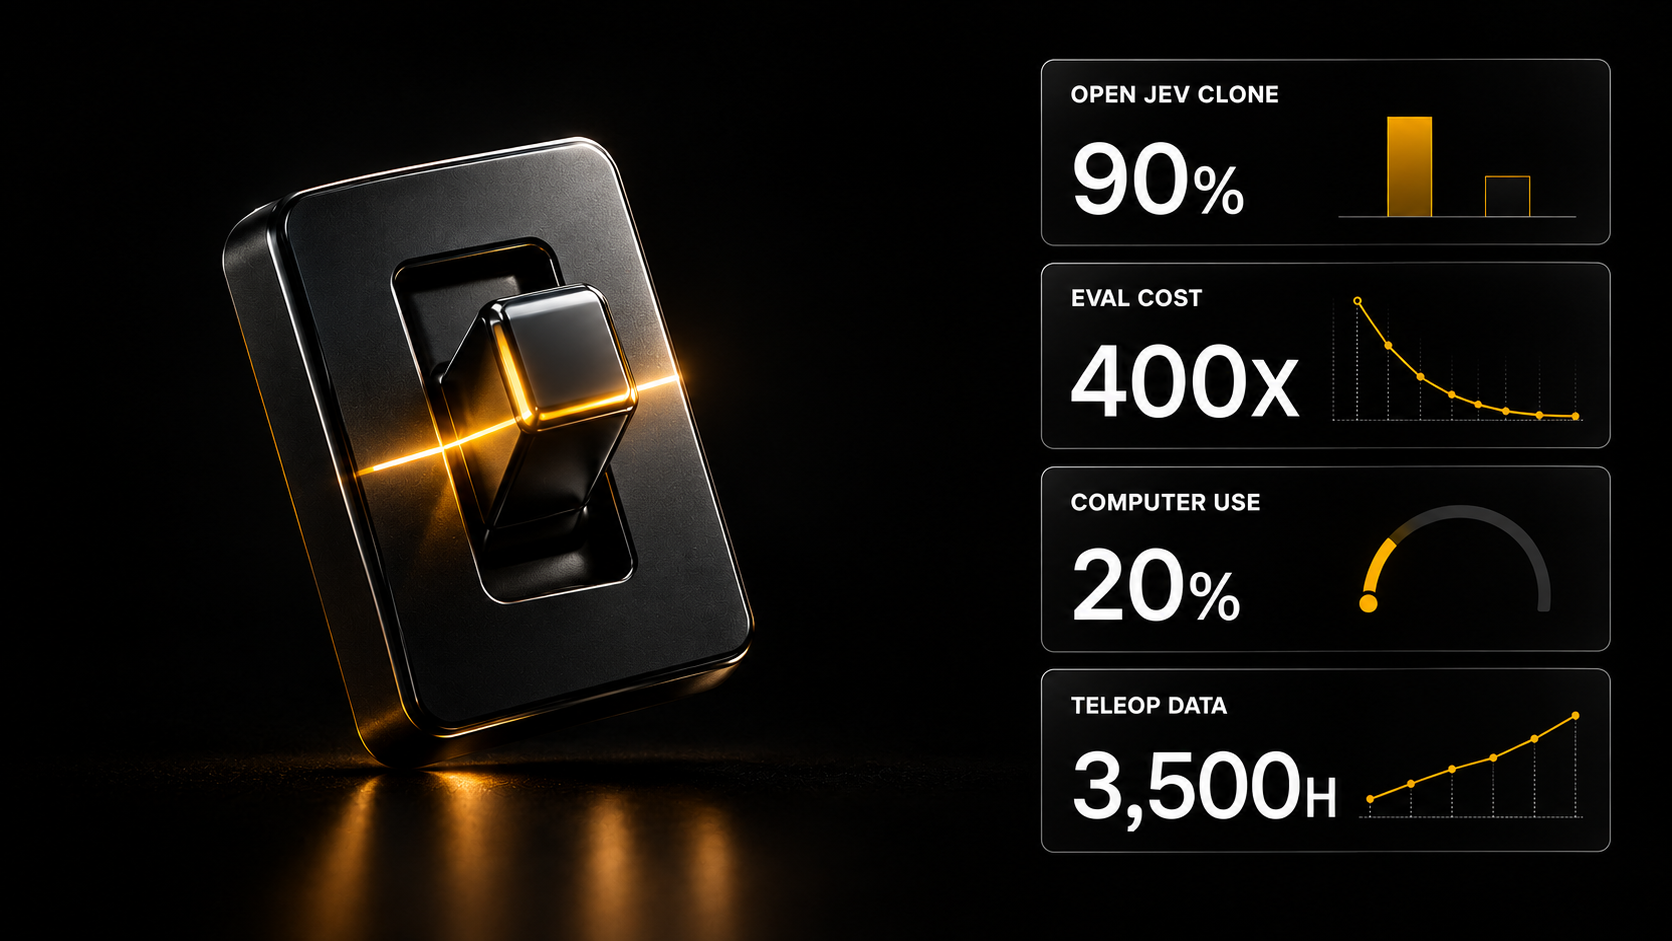
Решающую модель Jev воспроизвели в открытом виде за двое суток: клон на Qwen3.5-9B даёт 90% против 93% у оригинала. Claude Code v2.1.277 начал читать AGENTS.md, а замер Harness Tax показал, что кодинг-агенту хватает четырёх инструментов.
Главное сегодня
Jev: открытый клон на Qwen3.5-9B дал 90% против 93% у оригинала
Решающая модель Jev от TypeSafe AI получила открытые воспроизведения за двое суток, и лучшее из них отстаёт от оригинала на три процентных пункта. Решающая модель — это не генератор текста, а классификатор с калиброванной вероятностью: она отвечает не словами, а выбором из заранее заданной схемы. Bespoke Nimble собран как LoRA-донастройка Qwen3.5-9B на синтетических контрастных данных: на собственном наборе оценок базовая Qwen поднялась с 66% до 90%, тогда как Jev даёт 93%, при 100 мс на H100 и работе локально. На другом конце размеров — Kev-0.5B на Qwen2.5-0.5B, который запускается на MacBook Pro. Практический смысл, к которому пришла дискуссия 17 сентября 2026 года: это история не про чат, а про быстрый «System 1» рядом с большой моделью — маршрутизация, выбор цитат, эскалация. В Braintrust Jev уже доступен как модель-оценщик со стоимостью скоринга ниже прежней примерно в 400 раз, а калиброванная вероятность нужна там, где решение надо не угадать, а обосновать. 21 сентября 2026 года основатель TypeSafe AI объяснил замысел в интервью Latent Space: модели для прода, а не «для бога».
Claude Code v2.1.277 читает AGENTS.md, если CLAUDE.md нет
Anthropic добавила в Claude Code поддержку AGENTS.md — файла-инструкции, который до этого был конвенцией конкурентов. Версия v2.1.277 проверяет AGENTS.md, когда в проекте нет CLAUDE.md, и переключение вынесено в конфиг. Это признание AGENTS.md общим стандартом, а не чужой договорённостью: Саймон Уиллисон сразу отметил практическую выгоду — исчезает класс файлов-заглушек, которые существовали только чтобы сослаться на файл другого формата. Для команд, которые держат несколько кодинг-агентов на одном репозитории, это снимает ручную синхронизацию двух наборов правил. У нас в каталоге на 22 сентября 2026 года 10 453 скилла для Claude Code — как устроены сами скиллы и файл SKILL.md, разобрано в гайде по скиллам Claude Code.
Harness Tax: набор из read, write, edit и bash выходит на границу Парето
Замер показал, что четыре простых инструмента дают кодинг-агенту почти максимум качества при меньших расходах. Харнес — это обвязка агента: набор инструментов, разметка контекста, бюджет шагов и правила остановки. Анализ Harness Tax утверждает, что минимальный набор — чтение, запись, правка, командная строка — достигает границы Парето на бенчмарках, а всё сверх того чаще добавляет трат, чем результата. Рядом вышла работа An Empirical Study of Harness Design for Coding Agents: исход бенчмарка всё сильнее определяется структурой харнеса, а не базовой моделью. Отсюда практический вывод, который уже виден в стеках: фронтир на планирование, дешёвая модель на исполнение — GPT 5.6 Sol XHigh для плана, GLM 5.3 Flash для реализации, DeepSeek V4.1 Flash для остального.
Роботика: датасет ABC-130K — 3 500 часов телеопераций на стенде за $8 тыс.
Открытые данные для манипуляции выросли до 130 тысяч эпизодов, собранных на оборудовании стоимостью восемь тысяч долларов. ABC-130K описан как крупнейший открытый набор телеоперационных данных: 3 500 часов, больше 130 тысяч эпизодов, 195 задач, двурукий стенд за $8 тыс., открытые схемы железа, код обучения, симулятор и оценка. В базовой научной части заявлена корреляция симуляции с реальностью r = 0,91 по прогрессу задачи — то есть проверять политику можно в симуляторе, не гоняя робота. Публикация закрывает типичное возражение к робо-датасетам: дорогой стенд как барьер входа. Для сравнения масштаба: полный релиз ABC включает больше 400 часов симуляционных данных на 24 задачах и 5 850 размеченных эпизодов оценки политик.
Цифры и факты
- 2,7% WER у Grok Voice Transcribe 2.0 на финальных стриминговых транскриптах, задержка 0,49 с после конца речи, цена $0,20 за час стриминга и $0,10 за час обычной расшифровки — замер Artificial Analysis против 3,9% у предыдущей версии.
- Ниже 20% — результат всех фронтир-моделей на CUA-Bench, тесте работы клавиатурой и мышью в реальном времени на шести играх, три из которых держат закрытыми.
- 82,1% → 83,6% mAP@50 — прирост детекции у GPT-6 Astra в режиме высокого усилия по замеру Roboflow, при этом цена за изображение выросла с $0,050 до $0,101, а задержка с 11 до 32 секунд (детали).
- 2,48x на 512K и 7,59x на 1M контекста — ускорение обучения диффузионных языковых моделей на восьми H100 в библиотеке Turbo-dLLM.
- 105 493 скачивания за шесть дней у Swift Qwen 3.8 27B: первое место среди донастроек и девятое в трендах Hugging Face, рост с 24 тысяч на второй день.
- Меньше 6 ГБ весит Ternary Bonsai 2 (27B) — тернарная производная Qwen3.8-27B, вдевятеро меньше исходной, с заявленным сохранением 98% способностей; заявку о 98% в обсуждении сразу собрались проверять.
- Не меньше $1 млрд за пять лет — столько Anthropic и Accenture обещают вложить в независимую оценку фронтир-моделей.
Разные точки зрения: чего стоят демонстрации автономных агентов?
Спор идёт вокруг заявки Vals AI о том, что GPT-6 Astra прошла Factorio: Space Age за примерно двое суток по часам и 165+ игровых часов. Предмет спора не в самой игре, а в том, годятся ли такие ролики как доказательство способностей.
За. Игра с длинным горизонтом и производственными цепочками ближе к настоящей работе, чем короткие бенчмарки: агенту приходится держать план на сотни шагов и восстанавливаться после ошибок.
Нейтрально. Отдельные интеграции измеримы и без игр: браузерное применение назвали лучшим сценарием для решающих моделей, а плагин для Cline даёт такой модели браузер прямо в редакторе. Это проверяется на своих задачах за вечер.
Против. В обсуждении к заявке задали простые вопросы: 165 игровых часов за двое суток означают ускоренное время или паузы, а записи прохождения для проверки нет. Тот же скепсис звучит и в соседних демонстрациях: виртуальную лабораторию термоядерного реактора за четыре часа критиковали за отсутствие уравнений и методики — красиво, но проверить нечего.
Инструменты и приёмы
- Поставить решающую модель перед большой. Открытые клоны Jev уже можно пробовать локально: Laya на 421 млн параметров (энкодер ModernBERT-large плюс скоринг-голова) и openjev собираются в маршрутизатор, который решает, какой модели отдать запрос. Готовые сборки под задачи — в разделе open-source инструментов AI SKILLS.
- Урезать харнес и померить. Прежде чем добавлять агенту новый инструмент, стоит проверить гипотезу Harness Tax на своём наборе задач: оставить read, write, edit, bash и сравнить качество и расход с текущей конфигурацией.
- Считать стоимость шага, а не подписки. Стек из «фронтир на план, дешёвая модель на исполнение» дал одному из практиков снижение расходов примерно на два порядка с весны: цепочка Opus → Sonnet → GLM 5.2 → GLM 5.3 Flash. Готовые цепочки автоматизации, куда такие модели подставляются узлами, лежат в шаблонах автоматизаций.
Коротко
- Губернатор Калифорнии Гэвин Ньюсом подписал указ о созыве экспертной панели для рекомендаций по законам об ИИ, включая возможные «выключатели» и внешних наблюдателей — сообщает The Rundown.
- В рейтинге RSI-Exam первое место держит GPT-6-astra с 0,5126, второе место занял Fable 5.1 с 0,4813 — обновление автора теста.
- Fal выпустила H3 Max Lip Sync и заявляет первое место по скорости и качеству в своих замерах при медианном времени генерации 11 секунд — анонс.
- ProgramAsWeights компилирует функцию, описанную по-английски, в маленькую нейропрограмму, которая работает локально на процессоре с выключенным Wi-Fi — описание автора.
- Trycua открыла CUA-S1-FORMS — первую модель семейства небольших «System One» моделей для работы с интерфейсами — анонс.
- Figure выпустила Helix 2.5 — очередное обновление своей модели управления роботом, разбор в Superhuman AI.
- Итан Моллик в эссе «The Overhang» описывает разрыв между тем, что модели уже умеют, и тем, что организации успели внедрить — текст.