AliceAI-Foundation-80B: Yandex открыла веса — AI-дайджест
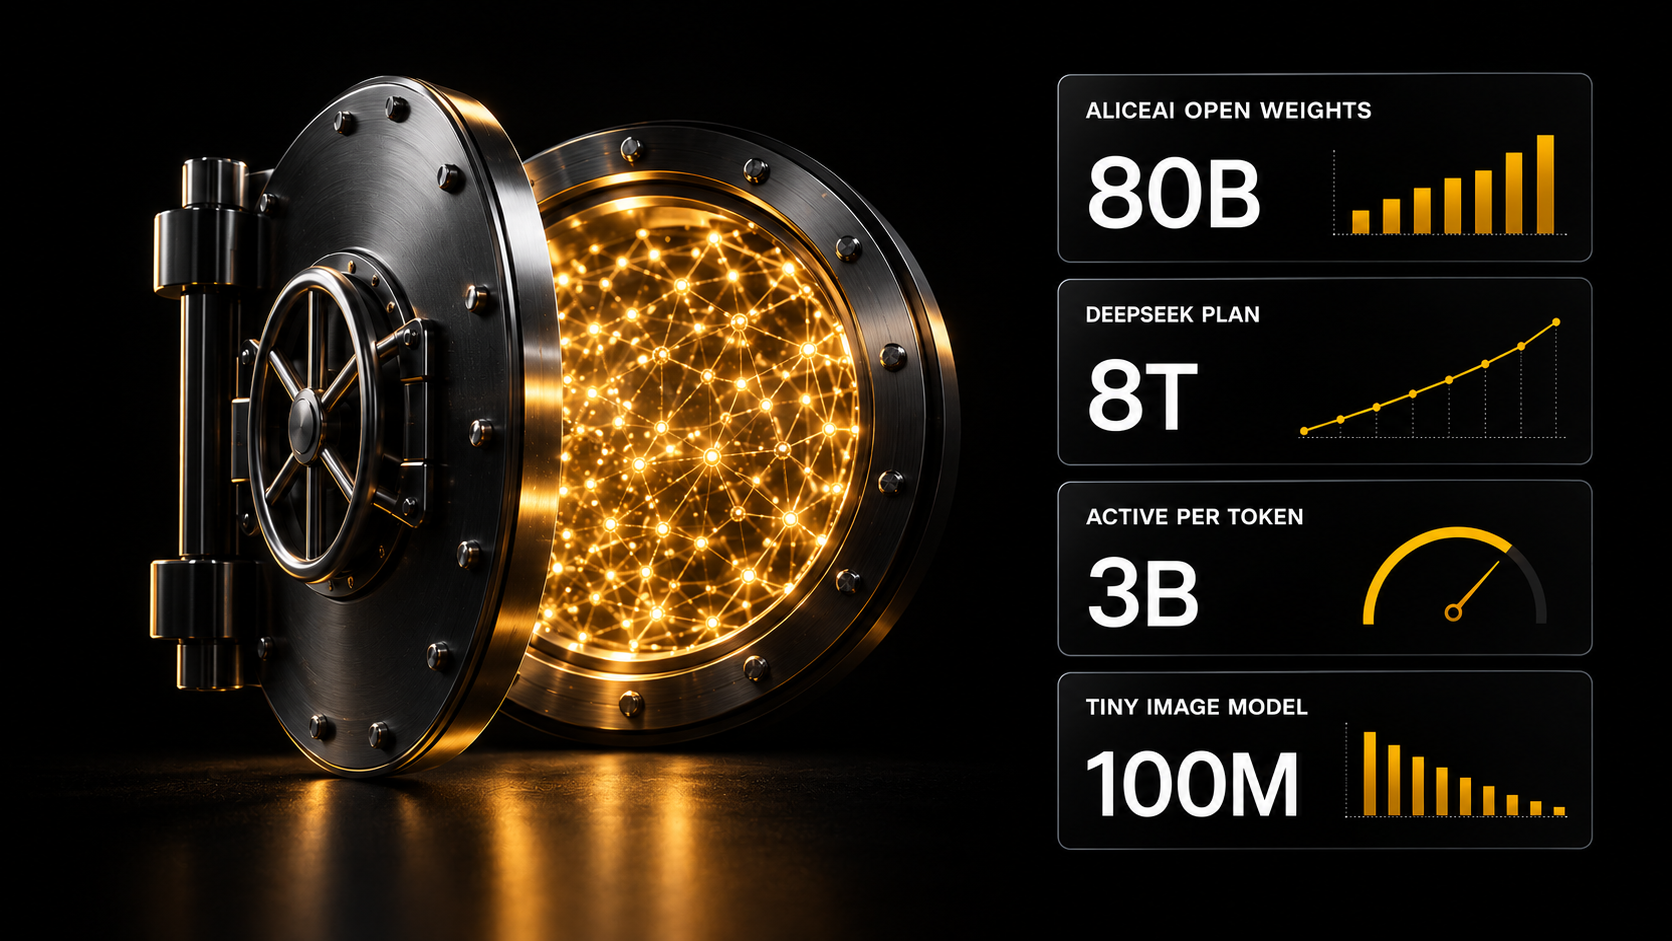
Yandex выложила открытые веса AliceAI-Foundation-80B-A3B — модель обучена с нуля, но пока без пост-обучения. В тот же день стали известны планы DeepSeek на 8 трлн параметров и Alibaba на 5–10 трлн, а слайд подтвердил линейку Qwen4.
Главное сегодня
Yandex выложила AliceAI-Foundation-80B-A3B — русскую модель, обученную с нуля
Yandex опубликовала открытые веса AliceAI-Foundation-80B-A3B-Base — модель на 80 млрд параметров, из которых на токен активны около 3 млрд. Запись «80B-A3B» читается так: активные параметры — это та часть весов, которую модель реально задействует на каждом шаге, поэтому разреженная модель считает быстрее плотной такого же размера. Карточка на Hugging Face описывает модель как обученную с нуля, а не как дообучение чужой; обсуждение в LocalLLaMA добавляет две практические детали: поддержки в llama.cpp на момент публикации нет, а архитектура, по разбору участников, близка к схеме Qwen3-Next 80B-A3B и дополнена механизмом внимания Kimi Delta Attention.
Главная оговорка — в слове Base. Это базовая модель без пост-обучения: ни инструкций, ни RLHF, ни выравнивания под диалог. Участники обсуждения 23 сентября 2026 года прямо просили не сравнивать её с Qwen и DeepSeek как есть — именно пост-обучение даёт то поведение ассистента, по которому модели обычно и оценивают. Отдельно прозвучал совет запускать любые сторонние веса в изолированной песочнице: вместе с весами приезжает код токенизатора и модели. Для русскоязычных задач это первая за долгое время попытка построить свой фундамент, а не надстройку над чужим; чего она стоит, покажет версия после пост-обучения. Открытые проекты, которые уже можно развернуть у себя, мы собираем в разделе Open Source.
Гонка размеров: DeepSeek готовит 2 трлн параметров и планирует 8 трлн
За сутки в открытый доступ попали планы сразу трёх китайских лабораторий, и все три — про кратный рост размера. По сообщению, которое разбирали в LocalLLaMA, DeepSeek обучает модель на 2 трлн параметров и планирует 8 трлн; там же приводятся текущие размеры линейки — Flash на 552 млрд и Pro на 1,6 трлн общих при 49 млрд активных, то есть разреженная схема. Первоисточник — публикация в X, технических подробностей обучения в ней нет. Alibaba, по обсуждению того же дня, готовит модель на 5–10 трлн параметров и представила собственный чип. И третье: слайд с конференции подтверждает линейку Qwen4 — Qwen4-27B рядом с Qwen4-Max, Qwen4-Flash и Qwen4-Plus.
Практический вывод участники сделали трезвый: модель на 5–10 трлн параметров для домашнего железа недостижима — в обсуждении её называют «минуты на токен», — и ценность таких моделей дойдёт до локального запуска только через дистилляцию в компактные версии вроде обсуждаемой Qwen4-27B. Прозвучал и содержательный контраргумент к самой гонке: с ростом размера модель начинает больше запоминать обучающие данные, а обобщать — не обязательно лучше. Подробный разбор того, как выбирать открытую модель под свою задачу, — в гайде по open-source LLM.
Биобезопасность: геномные модели уже собрали работающий вирус
Геномные языковые модели, обученные на ДНК, использовали для сборки полных геномов бактериофагов, которые затем синтезировали в работающие вирусы. Геномная языковая модель — это модель, предсказывающая последовательность ДНК так же, как обычная предсказывает текст, только алфавит у неё из четырёх букв. Об этом рассказал в подкасте Latent Space 23 сентября 2026 года Эрик Нгуен, сооснователь Radical Numerics: он участвовал в разработке моделей Evo и Evo 2 в Arc Institute, а другая команда Arc и Стэнфорда на их основе получила геномы фагов, которые оказались жизнеспособными.
Почему это стало возможно только сейчас — вопрос длины контекста, а не размера модели. Средний человеческий ген — около 60 тысяч букв, самый длинный доходит до 2,3 млн, весь геном — порядка 3 млрд; работать с такими последовательностями научились примерно три года назад, задолго до того, как фронтир-лаборатории начали объявлять миллионный контекст. Отсюда и спор о том, что с этим делать: в том же материале приводится позиция Клемана Деланга, что защитные возможности обязаны быть открытыми и не отставать от атакующих — открытые веса уже участвовали в разборе реальной атаки. Ровно две области, которые фильтры Anthropic помечают как чувствительные, — кибербезопасность и биология.
Google ERA: дерево экспериментов, из которого вышло минимум десять статей
Google построила систему, которая сама подбирает решение для любой научной задачи, если её удаётся записать в виде оценки, — и на ней получили не менее десяти публикаций. Устройство ERA (Empirical Research Assistance) описал в подкасте Latent Space Джон Платт, автор двух хрестоматийных алгоритмов машинного обучения. Модель держит дерево прошлых экспериментов-ноутбуков и на каждой итерации выбирает, какой из них мутировать, по правилу верхней доверительной границы — близкий родственник поиска по дереву Монте-Карло. Выбор оптимистичный, а не жадный, поэтому в работу иногда идёт и пятый по качеству вариант; мутаций предлагается около десяти за раз, а история ветки общая, так что ветви учатся друг у друга. Эволюционные алгоритмы известны с семидесятых — сработало это потому, что модель понимает, где искать: между поколениями Gemini 2.0 и 2.5 подход перешёл из «не работает» в «работает отлично».
Самое полезное в этом рассказе — предупреждение, а не результат. Соревнование Google по распознаванию конденсационных следов выиграли участники, заметившие ошибку в полпикселя в разметке: считать ли началом пикселя его угол или центр. Пятнадцать тысяч долларов приза это принесло, к решению задачи не приблизило ни на шаг — закон Гудхарта в чистом виде: показатель, ставший целью, перестаёт быть показателем. Совет Платта тем, кто начинает: сначала линейная регрессия или метод опорных векторов, и только потом всё остальное.
Цифры и факты
- 100 млн параметров и меньше 10 часов на одной H100 — столько, по заявлению авторов, потребовалось на обучение с нуля модели Supra2-IMG, рисующей картинки 256×256 примерно за 2 секунды на видеокарте и за 20 секунд на процессоре.
- Elo 1082 против 1052 — так Ming-Image-0.1-Design на 6 млрд параметров обходит Ideogram 4.0 Quality в рейтинге генерации интерфейсов среди открытых моделей (разбор скриншота); лицензия MIT.
- 5,7 из 17 задач SWE-bench-Live при размере файла 3,6 ГБ — результат квантованной сборки SharpSpark на базе Spark-X2.5-4B, заявленный автором для тех, у кого мало видеопамяти; на одну задачу уходит около 74 минут.
- 530 млн параметров на ноутбуке с 8 ГБ видеопамяти — размер непрерывно растущей модели mini-AGI, которую обучают с нуля потоком данных по одному примеру; в комментариях привели встречный опыт: у дописанных позже слоёв вклад оказался примерно в 23 раза меньше, чем у исходных.
- 18 МБ и 2–4 тыс. токенов — размер банка KV-кэша и срок его действия в проекте phantom-kv, который меняет поведение модели без правки весов; скептики в обсуждении считают приём разновидностью невидимого системного промпта.
- С 2,2–2,5× до 1,4–1,5× — во столько раз, по замеру пропускной способности Claude Code, подписка Max 20× сейчас выгоднее Max 5×: первая опустилась со 118 до 92 условных недельных единиц, вторая держится около 65.
- 15,2 ГБ видеопамяти — пик при запуске Qwen-Image-2.1 в int8 на карте с 16 ГБ, по отчёту пользователя.
Наша сводка по заявленным размерам недели (общие параметры / активные на токен):
| Модель | Размер | Статус |
|---|---|---|
| DeepSeek Flash | 552 млрд | выпущена |
| DeepSeek Pro | 1,6 трлн / 49 млрд | выпущена |
| DeepSeek (следующая) | 2 трлн, план 8 трлн | обучается |
| Alibaba (следующая) | 5–10 трлн | план |
| Yandex AliceAI-Foundation | 80 млрд / ~3 млрд | открытые веса |
Разные точки зрения: чего стоит заявление про сто решённых математических задач
Обсуждение дня крутилось вокруг утверждения, что внутренняя модель OpenAI за 24 дня обучения решила задачу Навье — Стокса и более ста открытых математических задач. Ни доказательств, ни статей, ни названия модели в исходном посте нет — есть только текст и упоминание консультативной группы из математиков.
За. Сам факт, что заявление обсуждают всерьёз, отражает смену вопроса: спор идёт уже не о том, может ли модель решать трудные задачи, а о том, успевают ли люди проверять то, что она выдаёт. Издание Superhuman AI вынесло тему в заголовок выпуска 22 сентября 2026 года.
Нейтрально. Самое содержательное возражение в ветке разделяет два умения: решать уже поставленную задачу и самостоятельно ставить новую, стоящую внимания. Второго в заявлении нет, а именно оно отличает исследователя от решателя.
Против. Вторая ветка по тому же поводу — откровенная сатира: ни бенчмарка, ни артефактов доказательства, ни независимой проверки. Пока нет ни одного проверяемого следа, разумнее считать это объявлением, а не результатом.
Инструменты и приёмы
- Получите вероятность, а не текст. Чтобы превратить обычную модель в классификатор, достаточно ограничить вывод одним токеном и включить выдачу логарифмов вероятностей: ответ «1» с логарифмом −0,00456 означает уверенность около 99,5%, а «0» с −5,395 — около 0,45%. Отдельная решающая модель для простых развилок в конвейере часто не нужна — нужен правильный режим вызова.
- Проверьте, что именно разрешает лицензия на картинки. Команда Qwen отдельно пояснила, что результаты генерации не считаются «лицензионными материалами» и права на созданные изображения остаются у пользователя. В обсуждении справедливо замечают, что текст лицензии на Hugging Face при этом всё ещё содержит пункт о запрете коммерческого использования материалов, — для клиентских работ ориентируйтесь на официальный текст, а не на пересказ.
- Удалённый чат — не удалённая память. Пользователи показали на примере, что сведения из стёртых переписок остаются в отдельной памяти ассистента и всплывают позже. Рабочая мера из той же ветки — вести чувствительные темы в проекте с изолированной памятью. Готовые формулировки под конкретные задачи — в библиотеке промптов.
Коротко
- Участники обсуждения Qwen4 ждут вариант с архитектурой, снижающей требования к видеопамяти, и надеются уместить Qwen4 Flash в 128 ГБ — ветка со слайдом.
- Вместе с моделями Ming-Image-0.1-Design опубликованы два агентских навыка — дизайн интерфейсов и превращение изображения в редактируемую презентацию — анонс.
- Claude Opus 5.5 заявлен как на 40% дешевле и более чем на 30% быстрее Opus 5 при цене $4 за миллион входных и $20 за миллион выходных токенов — разбор карточки релиза.
- Пятичасовые лимиты подписок Pro, Max и Team подняты, а сброс лимита теперь можно накопить и потратить когда нужно — обсуждение анонса.
- Таблицу бенчмарков Opus 5.5 выложили без методики, размеров выборки и погрешностей — ветка с разбором, и по ней GPT-6 Astra остаётся впереди в бизнес-процессах и агентных научных задачах.