Gemini 4 Argon: 1M токенов вывода за $2/$10 — AI-дайджест
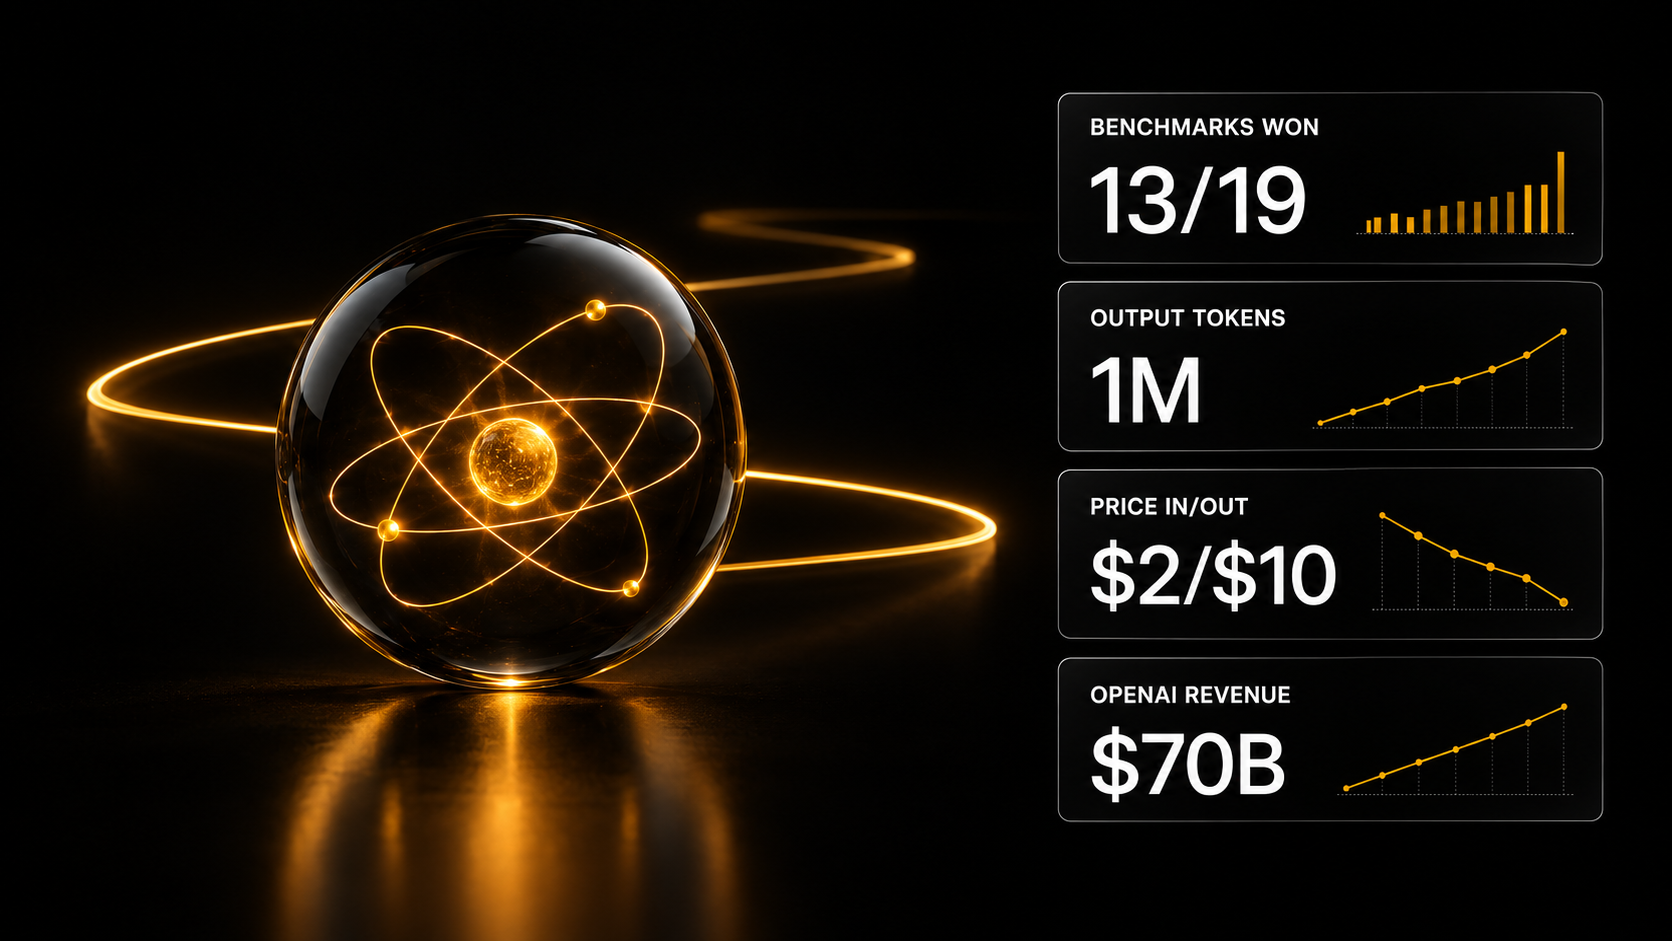
Google выпустила Gemini 4 Argon: первое место в 13 из 19 бенчмарков, до 1M токенов вывода и цена $2/$10 со скидкой. OpenAI приближается к $70 млрд годовой выручки.
Главное сегодня
Google выпустила Gemini 4 Argon: первое место в 13 из 19 бенчмарков и 1M токенов вывода
Google DeepMind представила Gemini 4 Argon — модель для кодинга, корпоративной работы со знаниями и киберзащиты, которая, по данным Google, обошла GPT-6 Astra и Claude Opus 5.5 в 13 из 19 опубликованных бенчмарков. Анонс вышел в аккаунте Google DeepMind и в блоге Google. На DeepSWE Gemini 4 Argon набирает 77,9% против 74,2% у Opus 5.5 и 74,1% у Astra, пишет The Rundown. Доступ получают сначала государственные пользователи и проверенные специалисты по киберзащите в программе Fairwind; разработчикам, компаниям и обычным пользователям Google откроет модель после доработки защит, сообщают Google и Демис Хассабис. Цена — $4/$20 за миллион входных и выходных токенов, со стартовой скидкой 50% без объявленного срока окончания — $2/$10, кэшированный вход дешевле на 95% (Филипп Шмид).
Gemini 4 Argon отвечает до 1M токенов за раз — почти в 16 раз больше прежних 64K
Google заявляет лимит вывода Gemini 4 Argon в 1 миллион токенов вместо прежних 64 тысяч — пост Google AI. Long Decode Continuation — это функция API, которая приостанавливает длинный ответ и продолжает его в следующих вызовах. Именно через неё Artificial Analysis получила 1M токенов вывода, а Vals указывает максимум 262K — цифра «1M» зависит от того, как модель вызывают. В замере Artificial Analysis Gemini 4 Argon набирает 53 балла индекса интеллекта — столько же, сколько GPT-6 Astra, и на балл больше GPT-6.1 Sol. Задача обходится Gemini 4 Argon в $1,99 против $3,26 у Astra по скидочной цене и в $3,98 по обычной; экономия идёт от цены, а не от бережливости: Argon тратит в среднем 62 тысячи выходных токенов на задачу против 27 тысяч у Astra.
Агенты на Gemini 4 Argon освободили в Google 300 ТиБ памяти и переводят 800 тысяч строк C/C++ на Rust
Google рассказала, что агенты на Gemini 4 Argon освободили более 300 ТиБ памяти в дата-центрах и переносят на Rust более 800 тысяч строк кода ядра на C/C++ — пересказ отчёта. В видеодекодере агенты заменили 32 тысячи строк SIMD-кода безопасным Rust, и существующий порт на Rust стал работать в 2,7 раза быстрее при идентичном результате. Команда Google также сообщает, что внутренние агентные циклы на Gemini 4 Argon помогли завершить доказательство гипотезы CK. Это заявления самой Google, независимой проверки этих цифр пока нет. Готовые сценарии агентов для своих задач собраны в каталоге шаблонов автоматизаций AI SKILLS.
OpenAI: около $70 млрд годовой выручки и переговоры о $30 млрд при оценке $1,4 трлн
OpenAI приближается к $70 млрд годовой выручки и ведёт переговоры о привлечении $30 млрд при оценке $1,4 трлн, а выход на биржу перенесён на следующий год — так сообщает The New York Times, данные приводит журналист Шри Муппиди. В те же дни OpenAI связала ядро кампании по извлечению скрытых рассуждений своих моделей с людьми, имеющими отношение к Moonshot AI: компания зафиксировала 16 000 попыток от более чем 4 000 пользователей за два дня и связанную активность ещё у 15 000+ пользователей (пересказ отчёта). Внешние исследователи пишут, что их атаки работали на GPT-6 Astra до этой недели, а исправления трудно доносить до всех версий продукта и сторонних хостингов (Йонас Гейпинг). Натан Ламберт считает уязвимость ответственностью поставщика API.
Итан Моллик: агенты научились работать группой сами — «горький урок» снова сработал
Итан Моллик 1 октября 2026 года признал, что ошибся в прогнозе: он считал, что работу группы ИИ-агентов придётся выстраивать как компанию, а новые модели справляются с этим сами. В эссе The Dot and the Swarm он пишет, что «попался на горький урок» — правило, по которому сложные правила, придуманные людьми, раз за разом проигрывают масштабу машинного обучения. Моллик проводит параллель с промптингом: громоздкие шаблоны и цепочки подсказок, которые вели модель по шагам, потеряли ценность, когда модели научились планировать шаги сами. Практический вывод для тех, кто строит агентов: меньше жёсткой оркестровки, больше постановки цели и проверки результата. Как ставить задачи моделям сегодня — в библиотеке промптов AI SKILLS.
Цифры и факты
- +14,4 пункта в answer recall@10 у открытой модели эмбеддингов Perplexity pplx-embed-v2-context-9b-preview против voyage-context-4 на закрытом тесте turbopuffer — при векторах 1 КБ int8 вместо 8 КБ (turbopuffer); веса открыты на Hugging Face.
- $12 за минуту стоит видео Wan 3.0 — первого места нового рейтинга AA-Video-T2V v2.0 (1080p, 68 000+ голосов людей); Seedance 2.5 на втором месте за $34,12 в минуту, MiniMax H3 статистически вровень за $4,80 (Artificial Analysis).
- В 4,8 раза больше токенов в секунду, чем на GB200, при той же скорости декодирования получила Cognition — первый клиент на Vera Rubin через CoreWeave (Cognition).
- 648 мс — медианное время до готовности у пересобранных Cloudflare Containers для агентов, в 6 раз быстрее прежнего; снимки состояния в бете (данные Cloudflare).
- 416 карточек про RAG, векторный поиск и эмбеддинги лежат в каталоге AI SKILLS на 2 октября 2026 года: 238 шаблонов автоматизаций, 120 скиллов для Claude Code и 58 open-source проектов (данные каталога платформы).
Разные точки зрения: Gemini 4 Argon — новый лидер или подгонка под тесты?
Независимые замеры подтверждают, что Gemini 4 Argon вернула Google в группу лидеров, но не в единоличное первенство: Artificial Analysis ставит её вровень с GPT-6 Astra (53 и 53 балла), а Vals — на первое место своего индекса с 68,9%. Бенчмаксинг — это подгонка модели под публичные тесты, из-за которой цифры в таблицах обгоняют реальную пользу. Именно в этом Gemini 4 Argon подозревают часть наблюдателей.
- За. Vals пишет, что Gemini 4 Argon безошибочно собрала 30 приложений Vibe Code Bench против 25 у Opus 5 и 24 у Astra, а результат на Terminal-Bench 4.0 вырос с 19,0% до 57,6%. В Text Arena модель первая с рейтингом 1525.
- Нейтрально. По данным Artificial Analysis, Gemini 4 Argon галлюцинирует в 15% ответов AA-Omniscience против 51% у Astra, но и точность у неё ниже — 50% против 63% (разбор). Модель осторожнее, а не всезнающе.
- Против. На юридическом бенчмарке Harvey Gemini 4 Argon набирает 19,6% против 25,42% у Muse Spark 1.2 (BlackHC); комментаторы допускают подгонку через данные предпочтений и спорят с цифрой DeepSWE. На Reddit пишут, что DeepSWE близок к насыщению, а показательнее паритет с Astra на Terminal Bench 4.
Инструменты и приёмы
- Правьте картинку десять раз подряд без «расползания». Ideogram 4.5 — модель редактирования без артефактов в многошаговых правках, открытые веса обещаны. За десять последовательных правок 94–99% нетронутой части картинки остаются идентичными. Промпт под правку соберёт генератор промптов AI SKILLS.
- Индексируйте одной моделью, ищите другой. У Cohere Embed 5 версии Pro и Fast живут в общем пространстве эмбеддингов: базу можно проиндексировать точной Pro, а запросы обслуживать дешёвой Fast. По данным Cohere, Fast обходит другие быстрые модели минимум на 6 пунктов при цене на треть ниже Pro.
- Кодируйте документ целиком, а не кусками. Perplexity в pplx-embed-v2-context кодирует весь документ один раз и собирает векторы фрагментов уже после — каждый фрагмент «помнит» контекст документа. Открытые инструменты для RAG и поиска по документам — в разделе Open Source AI SKILLS.
Коротко
- Upstage выпустила Solar Mini 4 — 35B параметров всего и 3B активных, 24 балла индекса Artificial Analysis при цене $0,10/$0,40 (Artificial Analysis); про открытые модели — в гиде по открытым LLM.
- Ling-3.1-flash — модель на 500B параметров, которую сравнивают с GPT-5.6 Sol и Opus 5, заняла второе место среди открытых моделей в Mobile App Arena.
- DeepSeek выпустила открытый набор инструментов для Huawei Ascend с TileLang, оптимизированным под Ascend 950.
- Грег Брокман отказался от обещанного второго пожертвования в $25 млн суперкомитету Leading the Future.
- Flow, делающая ИИ-инструменты для инженеров-«железячников», привлекла $50 млн в раунде B при оценке $750 млн.
- Factory расторгла договор с советником Крисом Дегнаном, обвинив его в контактах с Cognition; Cognition в тот же день назначила Дегнана CRO, а её CEO отрицает передачу сведений.
- В Nature вышла статья о первом сверхчеловеческом ИИ для игры Stratego — на обучении с подкреплением и вычислениях во время вывода при неполной информации.