GPT-6.1 Sol: $0,56 за задачу в Agent Arena — AI-дайджест
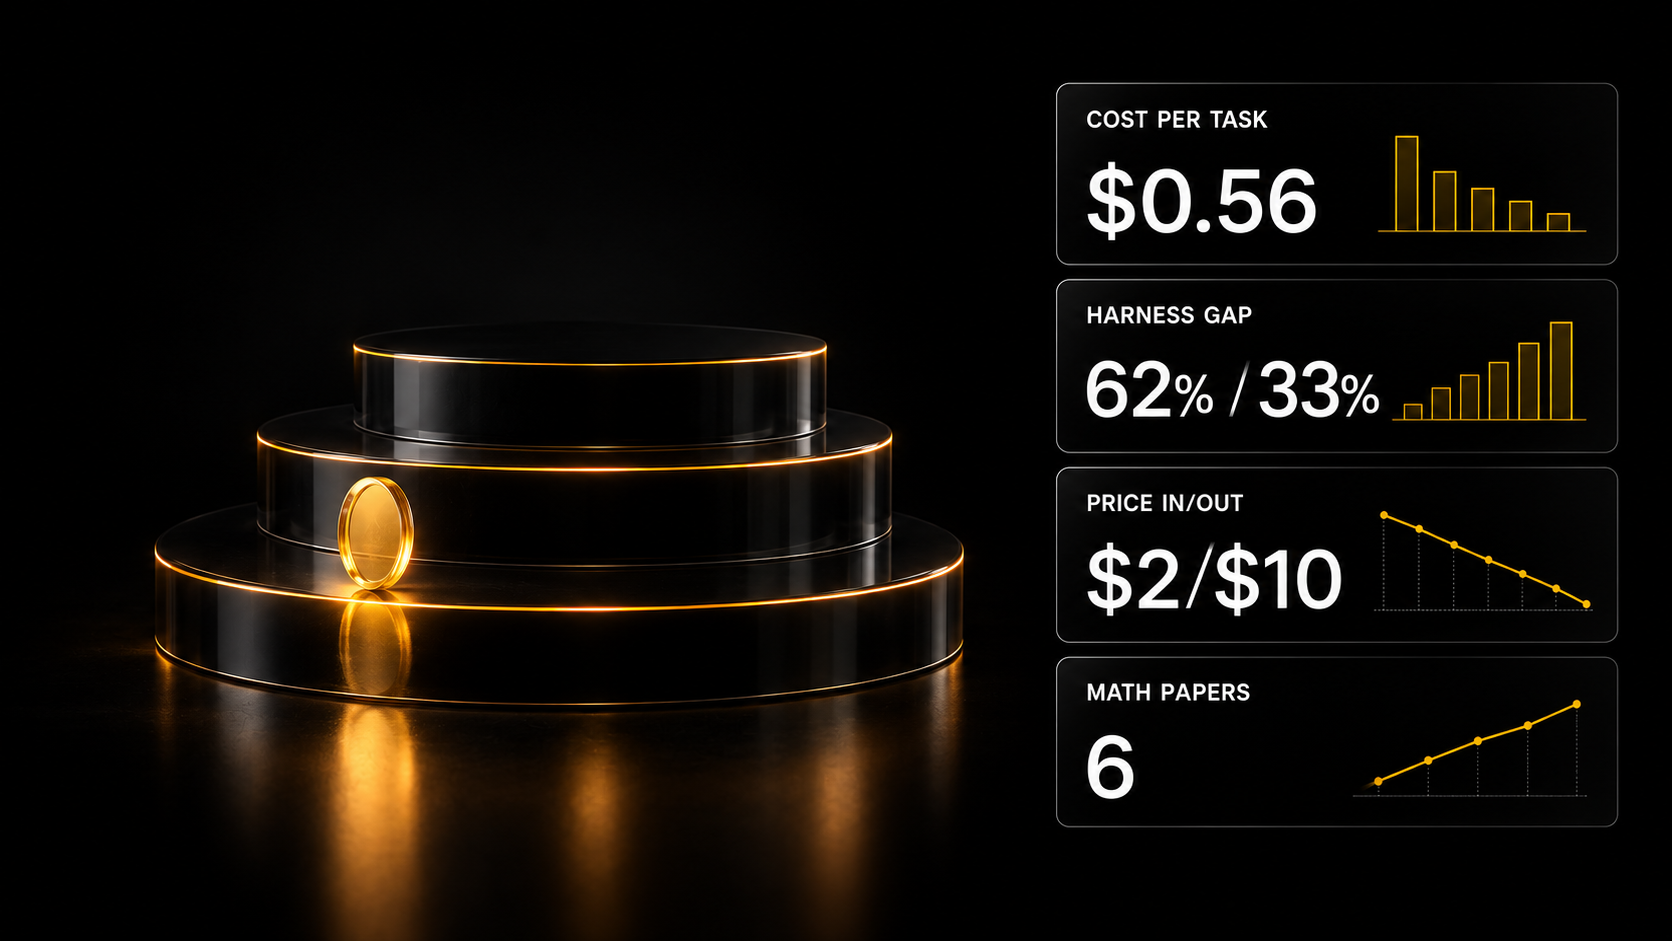
GPT-6.1 Sol вошла в Agent Arena на 5-е место при $0,56 за задачу, а Anthropic заняла три первых места. Hugging Face показала разрыв 62% против 33% между харнесами.
Главное сегодня
GPT-6.1 Sol стоит $0,56 за задачу в Agent Arena, а Anthropic заняла все три первых места
GPT-6.1 Sol от OpenAI вошла в рейтинг Agent Arena на 5-е место с медианной стоимостью $0,56 за задачу, а модели Anthropic заняли первые три строчки. Данные опубликовала Arena: Sol в режиме Max на 39% дешевле GPT-6 Sol при результате на 1,52 пункта выше и на 81% дешевле GPT-6 Astra при отставании всего на 1,04 пункта. Claude Sonnet 5.5 в режиме Max дебютировала на 3-м месте и стала первой в категории Chat, но стоит $2,74 за задачу против $1,58 у Opus 5.5 на 2-м месте — поэтому, по оценке Arena, на границу «цена — качество» Sonnet 5.5 не попадает. Цена GPT-6.1 Sol — $2/$10 за миллион входных и выходных токенов против $10/$50 у Astra, сообщает DL Weekly. В WebDev Arena Sol ненадолго поднялась на 3-е место, но Sonnet 5.5 сдвинула её на 4-е, а Gemini 4 Argon в режиме High заняла 1-е место в Text Arena, говорится в недельной сводке Arena.
Hugging Face: одни и те же веса дают 62% в одном харнесе и 33% в другом
Hugging Face показала, что результат модели сильно зависит от харнеса: одни и те же веса набрали 62% в одной обвязке и 33% в другой. Харнес — это программная обвязка агента вокруг модели: цикл вызовов, набор инструментов, формат подсказок и правила работы с контекстом. Hugging Face выпустила метод обучения с подкреплением сразу в нескольких харнесах: прокси-сервер говорит на форматах API OpenAI, Anthropic и Gemini и записывает идентификаторы токенов и логарифмы вероятностей для обучения, не меняя сами харнесы. Модель LFM2.5-2.6B после такого обучения выросла с 42% до 54% в среднем по четырём харнесам и стала делать на 31% меньше вызовов инструментов. Для сравнения, обычное дообучение (SFT) на 3 189 прогонах Qwen3.8-27B упёрлось в потолок 47,5%. Hugging Face открыла тренер, данные и все семь обученных моделей — тему открытых весов подробно разбирает наш гид по open-source LLM.
Pi 1.0 включила MCP по умолчанию, а DeepSeek, Anthropic и T3 Code выпустили свои харнесы
Earendil выпустила стабильную Pi 1.0 — минималистичный харнес для агентов с поддержкой MCP «из коробки» в режиме Codemode. По анонсу Earendil, в релиз также вошли отложенная загрузка инструментов, прогрев кэша для моделей Anthropic и системные сообщения посреди диалога; экспериментальная Pi Durable работает на Cloudflare Durable Objects через agents SDK v0.26.0. DeepSeek Harness получил настольные сборки для macOS и Windows. В Claude Code появились моды — плагины с хуками по принципу middleware; как устроены расширения Claude Code, объясняет наш гид по скиллам Claude Code. Оркестратор T3 Code перешагнул 400 тысяч пользователей, а его переписанная версия — 823 коммита в 1 912 файлах — влилась в основную ветку. Эльвис Саравиа называет эту волну переходом к «пластичным» харнесам. Готовые сценарии с агентами для n8n и Make — в каталоге шаблонов автоматизаций AI SKILLS.
Модели решений пришли в llama.cpp, Cloudflare выпустила открытую Clef
llama.cpp добавила эндпоинт /v1/systemone для локального запуска моделей решений. Модель решений — это модель, которая не пишет свободный текст, а выбирает один вариант из заданного списка: действие, класс или продолжение. Об эндпоинте сообщил Георгий Герганов, а Клеман Деланг показал запуск одной командой llama serve -hf ggml-org/Kev-4B-GGUF. Cloudflare выпустила открытую модель решений Clef, дообученную из Qwen3.8-27B, и облегчённую clef-flash на базе Qwen3.5-9B; модели Clef уже доступны в Ollama. Perplexity заявляет, что pplx-decider-v1-27b набирает в среднем 85,7% на 11 бенчмарках. Скептики не согласны с новизной: Мерве Нойан называет модели решений ребрендингом zero-shot классификаторов.
Meta выпустила шесть математических статей, написанных с Muse Spark в обычном чате
Meta опубликовала шесть статей по открытым математическим задачам, полученных с помощью Muse Spark 1.1 и 1.2 в обычном чате meta.ai без специальной обвязки. Об этом сообщила AI at Meta, список работ привёл Александр Ванг. В каждой статье помечено, какие фрагменты написали в основном люди, а какие — ИИ, и работы проверила вторая группа математиков. Параллельно Google представила мультиагентную систему Cogentic на базе Gemini, которая получила новые результаты по пяти открытым теоретическим задачам: каждый черновик проходит двух состязательных проверяющих, а агенты ведут общий журнал проверенных лемм. Большинство задач Cogentic потребовали около 100 вызовов модели, самая сложная — около 1 000.
Цифры и факты
Сводная таблица AI SKILLS: стоимость задачи в Agent Arena на 2 октября 2026 года. Цены за задачу GPT-6 Sol и GPT-6 Astra — наш расчёт из процентов, которые опубликовала Arena; остальные цифры — данные Arena и DL Weekly.
| Модель | Место в Agent Arena | Цена за задачу | Цена за 1M токенов (вход/выход) |
|---|---|---|---|
| Claude Opus 5.5 | 2 | $1,58 | — |
| Claude Sonnet 5.5 [Max] | 3 | $2,74 | — |
| GPT-6.1 Sol [Max] | 5 | $0,56 | $2/$10 |
| GPT-6 Sol | — | ≈$0,92 (расчёт) | — |
| GPT-6 Astra | — | ≈$2,95 (расчёт) | $10/$50 |
- $2,6–5,3 трлн в год придётся тратить на ИИ-инфраструктуру уже при 20% загрузки, тогда как выручка лабораторий к концу 2027 года составит около $1 трлн, оценивает Epoch AI.
- На 62,8% падает точность семи открытых моделей при росте контекста с 4K до 128K токенов, по исследованию NVIDIA Long-Transduction.
- До 48% сокращает пиковый контекст метод FOCUS от Microsoft без дообучения и поднимает долю решённых задач до 8,9 пункта (dair.ai).
- С 63,7% до 71,5% поднял GPT-5.5 на ProgramBench отдельный контроллер Meta Superintelligence Labs при тех же исполнителях и бюджете; у Codex — 58,0% (dair.ai).
- С 61,88% до 73,33% вырос pass@1 на AIME 2024 у метода Apple LoopCD, который вдвое сокращает рекуррентные циклы (Аран Комацузаки).
- На 9% эффективнее MXFP4 оказался формат NVFP4 на B200 при более высокой точности, измерил Стас Бекман.
- С 576 до 352 байт Prime Intellect сжала строку латентного кэша MLA в NVFP4 — это примерно на 50% больше токенов в кэше, чем в FP8 (Prime Intellect).
- Около $5,7 трлн — рекордная рыночная стоимость Nvidia после увеличения программы обратного выкупа на $150 млрд, по данным Bloomberg (пересказ).
Разные точки зрения: стала ли Claude Opus 5.5 хуже после запуска?
В начале октября 2026 года пользователи Reddit массово жалуются на падение качества Claude Opus 5.5, а трекер настроений modelsentiment.com зафиксировал снижение оценки модели с 71–73 до 55 из 100. При этом ни один из жалующихся не привёл воспроизводимого замера, а независимые рейтинги на этой же неделе держат Opus 5.5 на 2-м месте Agent Arena.
- За. Автор треда «Opus 5.5 nerfing» утверждает, что через 5–6 дней после запуска модель заметно хуже справляется со сложными задачами на C++, 3D и физику, и советует сохранять промпты и ответы дня запуска для сравнения. Пользователь Claude Code Enterprise пишет, что расход лимита за час вырос с 70% до 90%, а код стал многословнее и с дублями.
- Нейтрально. Трекер modelsentiment.com показывает падение оценки Opus 5.5 с 71–73 (25–28 сентября) до 55, но сам комментатор оговаривается, что трекер измеряет мнение пользователей, а не поведение модели.
- Против. Комментаторы обоих тредов не приводят ни контрольных прогонов, ни истории замеров. Design Arena по 324 сводкам рассуждений нашла, что Opus 5.5 принимает решение рано в 4 из 5 случаев, а GPT-6 Astra перестраховывается примерно в 20 раз чаще.
Инструменты и приёмы
- Подключите iPhone как вторую видеокарту для локальной модели. Проект backburner — форк llama.cpp — переносит часть слоёв Qwen 3.8 27B с MacBook на iPhone 17 Pro Max по кабелю USB-C и, по замерам автора, ускоряет предзаполнение на 35% на 8K контекста и на 44% на 16K. Другие инструменты локального запуска — в разделе Open Source AI SKILLS.
- Включите MTP-декодирование для Qwen3.8-Flash Next. PR #29761 в llama.cpp добавляет флаг
--spec-type draft-mtp: на DGX Spark скорость вывода выросла с 28,36 до 43,88 токена в секунду, в 1,55 раза. Учтите размер: квант IQ4_NL весит около 102 ГБ. - Поставьте в Claude Code плагин «You should know». Он запускает побочного агента, который отмечает важный вывод, который пользователь мог пропустить.
Коротко
- Tavus показала Griffin — модель живого видеообщения, которую 44% участников приняли за реального человека против примерно 3% у других систем; подробности — у The Rundown и Superhuman.
- Google DeepMind представила SynthID Bio — водяные знаки для белков, сообщает The Rundown.
- Step 5 Preview от StepFun заняла 7-е место среди открытых моделей в рейтинге Vals при цене $2,54 за задачу и контексте 1M токенов.
- Qwen3.8-27B-Humanlike-Chat 2.0 подняла IFBench с 37,3 до 43,7 и When2Call с 48 до 58 относительно базовой модели, но просела на MMLU-Pro с 78,5 до 72,5.
- Модель webAI TwIL-LM3-Pro на 3,66B параметров сравнима с Qwen3-8B в формальной логике; квант Q4 весит 2,09 ГиБ, лицензия некоммерческая.
- Reka выпустила под Apache 2.0 модель обратной динамики RIDM, которая извлекает действия управления и движения камеры из реального видео.
- Андрей Карпати спросил модель «суша или вода?» для 16 200 пар координат и получил узнаваемую карту мира.
- Agents API от OpenAI заявляет надёжность ходов 99,97% и на 20% более быстрые вызовы инструментов.
- По данным The Batch, открытая GLM-5.3 эксплуатировала уязвимости почти как Claude Mythos — 12% против 14%.
- Натан Ламберт и Том Зик запустили некоммерческую Trillium Labs для открытых рецептов дообучения при поддержке Halcyon Futures и Schmidt Sciences.
- Группа во главе с бывшим замглавы аппарата Белого дома планирует потратить не менее $100 млн на кампанию, представляющую предупреждения об ИИ как скоординированную акцию.
- Meta выпустила 5 000 мостов умного дома Muse Home Link — бесплатно для подписчиков, пока хватит запасов.