GPT-6.1 Sol и Argon: $2/$10 за 1М токенов — AI-дайджест
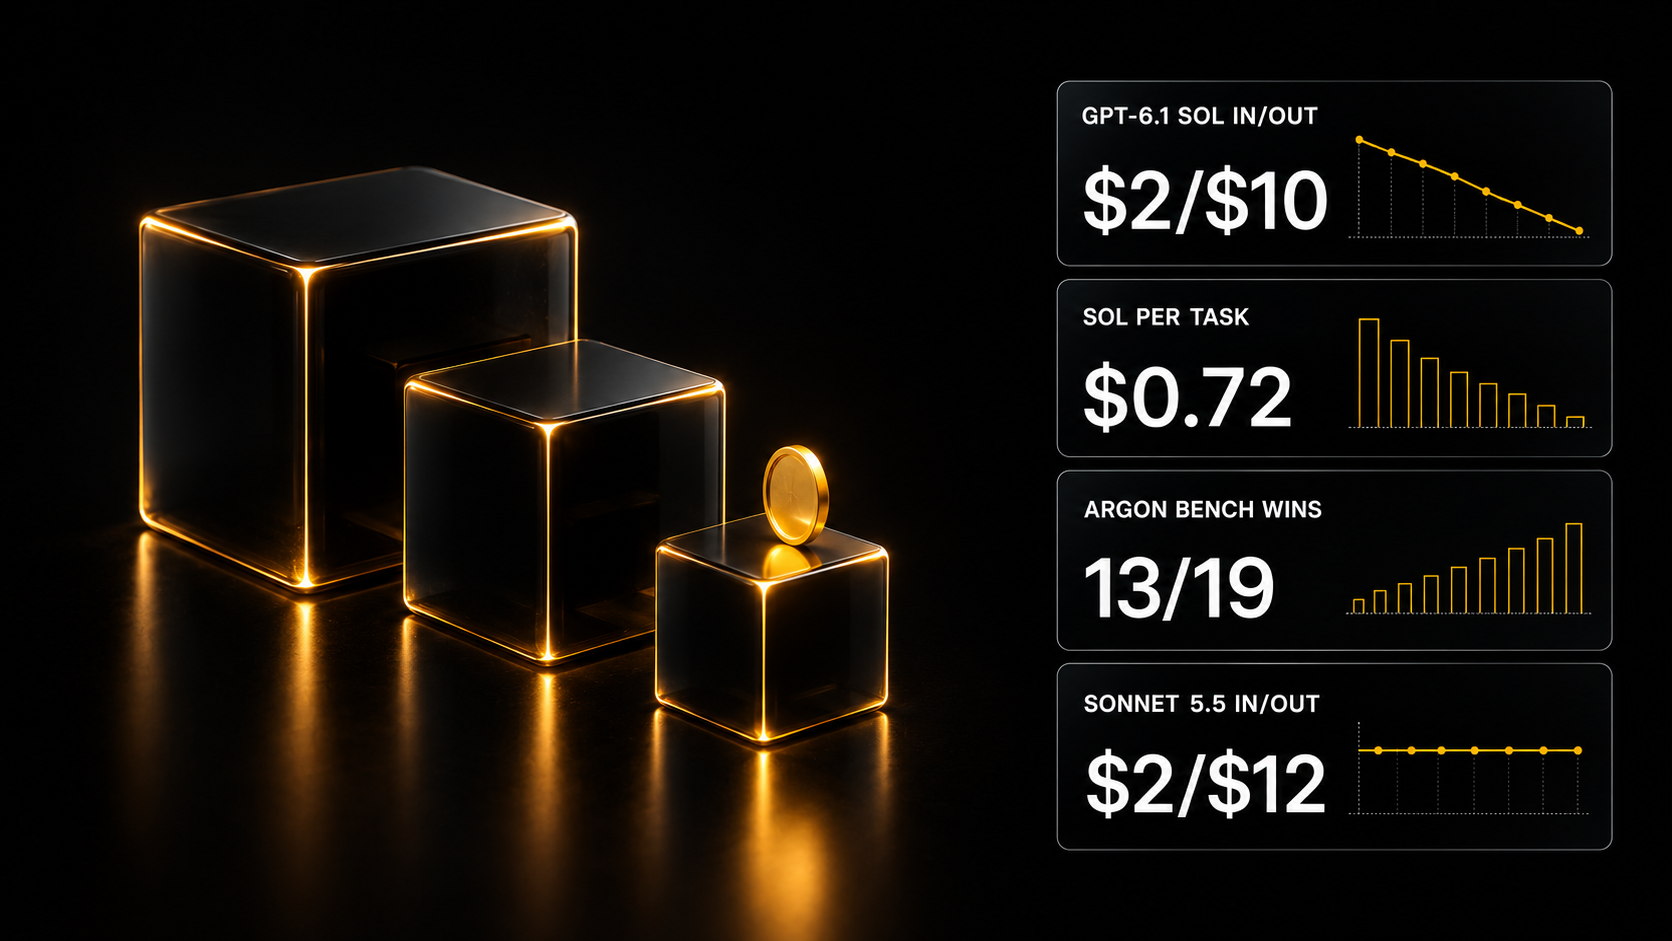
OpenAI продаёт GPT-6.1 Sol по $2/$10 за 1М токенов, Google открыла Gemini 4 Argon узкому кругу, а Sonnet 5.5 держит цену $2/$12 и входит в тройку Agent Arena.
Главное сегодня
GPT-6.1 Sol: $2/$10 за 1М токенов и $0,72 за задачу вместо $3,26 у Astra
OpenAI выпустила GPT-6.1 Sol по цене $2 за миллион входных и $10 за миллион выходных токенов — в пять раз дешевле флагмана GPT-6 Astra ($10/$50). На DevDay 29 сентября 2026 года компания подала модель как «почти уровень Astra за пятую часть цены». Независимый замер Artificial Analysis показал $0,72 за задачу индекса интеллекта на максимальном усилии против $1,04 у GPT-6 Sol и $3,26 у Astra; экономия идёт от меньшего числа ходов и более дешёвого чтения кэша, а не от меньшего числа токенов. Там же OpenAI исправила ошибку кодирования изображений: у GPT-6 Luna индекс вырос на один пункт. Сэм Альтман назвал Sol самой быстрорастущей моделью компании.
Dots: OpenAI запустила постоянных агентов на собственном облачном компьютере
OpenAI представила Dots — персональных агентов, которые работают круглосуточно, пишут вам первыми и подключаются к более чем 4000 приложений. Каждый dot питается GPT-6 Astra и работает на собственном облачном компьютере; пользователь задаёт границы: что агент делает сам, что требует одобрения, что запрещено. По описанию Ben's Bites, Dot — это бесконечный чат-оркестратор, который запускает задачи в Codex и ChatGPT Work и отчитывается о статусе; на тарифах Pro полагается один Dot. Итан Моллик в One Useful Thing называет такие продукты «Clawlike» — наследниками OpenClaw — и отмечает, что агенты всё чаще находят ошибки хозяина, а не наоборот. Конкурирует с Dots приложение Muse от Meta, которое, по его словам, сейчас занимает первое место в App Store.
Gemini 4 Argon: Google заявляет лидерство в 13 из 19 бенчмарков, но доступ закрыт
Google DeepMind представила Gemini 4 Argon со стандартной ценой $4/$20 за 1М токенов и скидкой 50% (до $2/$10) без объявленной даты окончания. Доступ пока получают только государственные пользователи и проверенные специалисты по кибербезопасности в программе Fairwind — об этом пишут Google DeepMind и The Rundown AI (1 октября 2026 года). По данным Google, Argon занимает первое место в 13 из 19 опубликованных бенчмарков против GPT-6 Astra и Claude Opus 5.5, на DeepSWE набирает 77,9% против 74,2% у Opus 5.5 и допускает до 1М токенов вывода. Artificial Analysis дал модели 53 пункта индекса — наравне с Astra.
Claude Sonnet 5.5: цена прежняя ($2/$12), на 30% быстрее и #3 в Agent Arena
Anthropic выпустила Claude Sonnet 5.5 28 сентября 2026 года по цене Sonnet 5 — $2/$12 за 1М токенов — и заявляет скорость выше на 30% и стоимость задачи ниже до 30%. Компания называет модель «явным улучшением» относительно Sonnet 5. По данным Vals AI, у модели контекст 1М токенов и вывод до 128К. В Agent Arena Sonnet 5.5 дебютировала на третьем месте и первой в категории Chat, но по $2,74 за задачу против $1,58 у Opus 5.5. Есть оговорка: Artificial Analysis зафиксировала на максимальном усилии около 193 тысяч выходных токенов на задачу — рекорд их замеров. Сам Anthropic советует максимальное усилие Sonnet не включать.
Decision-модели: Cloudflare, Perplexity и OpenAI делают классификацию отдельным слоем
Cloudflare, Perplexity и OpenAI за неделю выпустили decision-модели — быстрые модели, которые выбирают один ответ из заданного списка. Decision-модель — это небольшая модель, которая получает вопрос и фиксированные варианты ответа и возвращает вероятности по ним, без свободного текста. OpenAI запустила Decisions API на GPT-6 Luna для почти мгновенной классификации и маршрутизации. Perplexity выложила pplx-decider-v1-27b на базе Qwen3.8-27B: входные токены стоят $0,04 за миллион, выходные бесплатны, веса открыты. У Cloudflare два decision-модуля Clef с открытыми весами под Apache 2.0. Скептики вроде @mervenoyann считают это ребрендингом zero-shot-классификаторов.
Цифры и факты
Наша сводка цен моделей недели (за 1М входных / выходных токенов, по данным источников выше и ниже):
| Модель | Вход / выход | Примечание |
|---|---|---|
| GPT-6.1 Sol | $2 / $10 | $0,72 за задачу по замеру Artificial Analysis |
| Claude Sonnet 5.5 | $2 / $12 | контекст 1М, вывод до 128К |
| Gemini 4 Argon | $4 / $20 | с акцией 50% — $2 / $10; $1,99 за задачу |
| GPT-6 Astra | $10 / $50 | $3,26 за задачу |
| GPT-6 Astra Ultrafast | $60 / $300 | в шесть раз дороже обычного, до 300 токенов/с |
| Solar Mini 4 | $0,10 / $0,40 | 35B всего / 3B активных, вес закрыт |
- Планы ChatGPT: Pro 100 даёт 5× объёма Plus, Pro 200 — 10×, новый Pro 500 — 25×; пользователи Pro 200 потеряли примерно половину прежней ценности и жаловались.
- Vals Index: Argon первая с результатом 68,9% и средней стоимостью $15,68 за задачу, а на Vibe Code Bench собрала 30 приложений идеально против 25 у Opus 5 и 24 у Astra.
- Hugging Face: одни и те же веса набирают 62% в одной обвязке и 33% в другой — результат агента зависит и от обвязки, а не только от модели.
Разные точки зрения: стала ли Gemini 4 Argon новым лидером?
Argon возглавила Vals Index с 68,9% и вошла в топ-5 на 20 из 22 тестов Vals, но Epoch AI при этом ставит на первое место Opus 5.5 (ECI 167), а Sonnet 5.5 примерно равна Fable 5.1 (165). Это разные наборы тестов, а не взаимозаменяемые рейтинги.
За. Vals называет Argon первой в совокупном индексе, а Google сообщает, что новые версии Gemini теперь проходят недели испытаний тысячами внутренних инженеров. На Arena Argon заняла первое место в Text Arena.
Нейтрально. Artificial Analysis ставит Argon вровень с Astra (53 пункта), но экономия — от цены: Argon тратит 62 тысячи выходных токенов на задачу против 27 тысяч у Astra.
Против. Опубликованная версия Bloomberg приписывала модели слабый код со слов анонимных источников, но следом появился ответ старшего инженера DeepMind, отвергающий этот вывод. На юридическом тесте Harvey Argon набрала 19,6% против 25,42% у Muse Spark 1.2; другие комментаторы подозревают подгонку под предпочтения. Вопрос о реальном качестве кода остаётся открытым.
Инструменты и приёмы
- Моды для Claude Code. Claude Code теперь поддерживает TypeScript-моды, которые меняют поведение, интерфейс и функции и распространяются плагинами; Anthropic показала механизм на
/diffи поддержкеAGENTS.md. Если вы пишете свои скиллы, начните с [руководства по скиллам Claude Code](/blog/claude-code-skills-guide) и каталога скиллов AI SKILLS. - Sonnet 5.5 вместо Opus на обычных задачах. Anthropic позиционирует модель для «повседневных задач вроде исправления багов»; по словам @edwinarbus, максимальное усилие лучше не включать — по умолчанию Claude Code использует среднее.
- Decision-модель локально. llama.cpp добавил эндпоинт
/v1/systemone; модель запускается командойllama serve -hf ggml-org/Kev-4B-GGUF— пост @ClementDelangue. Подойдёт для классификации в воркфлоу — готовые сценарии есть в шаблонах автоматизаций.
Коротко
- FLUX 3 Image от Black Forest Labs: генерация до 4K и до десяти референсов, скидка 50% на API до 8 октября 2026 года; анонс.
- Tavus Griffin: по заявлению компании, 48% участников приняли модель за человека против менее 3% у прежних систем.
- Meta Muse Home Link: 5000 устройств бесплатно для подписчиков, пока не кончатся.
- SWE-sweep: бенчмарк на 100 репозиториях, 22 языках и около 4000 реальных багов — лучшие модели решают менее 5%.
- Pi 1.0 вышел вместе с Pi Durable — долговечное выполнение как примитив обвязки.
- Claude Haiku 5.5 «завершит семейство в ближайшие недели», по словам @mikeyk.