Qwen3.8-27B на RTX 4090: 115 токенов/с — AI-дайджест
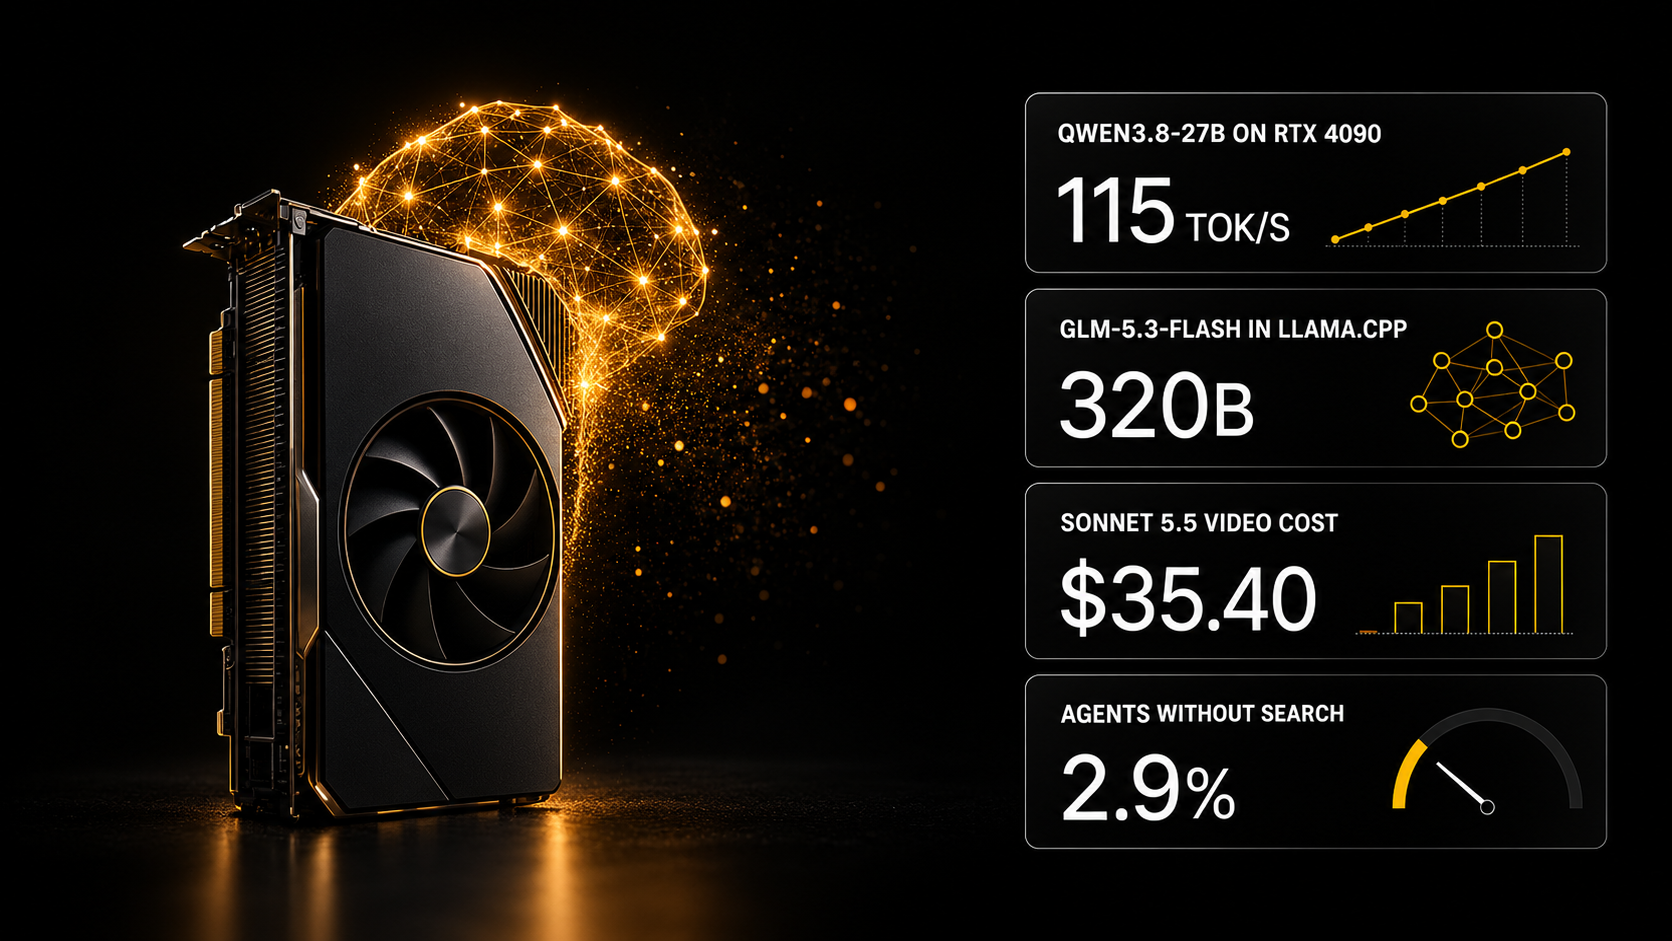
Qwen3.8-27B выдаёт 115 токенов в секунду на одной RTX 4090, GLM-5.3-Flash на 320B пришла в llama.cpp, а Claude Sonnet 5.5 собрал 30-секундный ролик из кода за $35,40.
Главное сегодня
Qwen3.8-27B на одной RTX 4090: 115 токенов в секунду и 40 из 43 скрытых тестов DeepSWE
Открытая модель Qwen3.8-27B в квантизации IQ4_XS выдаёт 115 токенов в секунду на одной видеокарте RTX 4090 с 24 ГБ памяти и проходит 40 из 43 скрытых тестов в задаче бенчмарка DeepSWE. Автор замера на r/LocalLLM запускал файл Qwen3.8-27B-UD-IQ4_XS от Unsloth весом 14,25 ГБ через llama.cpp с контекстом 196 608 токенов, кэшем ключей и значений в q8_0 и спекулятивным черновиком MTP; пик видеопамяти — 22 934 МиБ. Квантизация — это сжатие весов модели до меньшего числа бит на параметр, чтобы она поместилась в память обычной видеокарты. Сам автор оговаривает пределы: все 109 существующих тестов прошли, но задача целиком засчитана как непройденная, а у фронтирных моделей на той же задаче доля полных прохождений 85,3% по данным DeepSWE v1.1. Это результат одной задачи из 113, а не равенство с фронтиром. Подробнее о запуске открытых весов — в нашем гиде по open-source LLM.
GLM-5.3-Flash в llama.cpp: модель на 320B с текстом и зрением теперь запускается локально
В llama.cpp влит pull request #27773, который добавляет поддержку GLM-5.3-Flash (GLM5-Next) — гибридной модели на 320 млрд параметров для текста и изображений. По описанию в r/LocalLLaMA, реализация добавляет индексацию DSA, гибридную индексированную память и отдельный путь предобработки изображений glm5v, а также переиспользует слои KDA из Kimi-K3 и блоки смеси экспертов в стиле DeepSeek. Проверка на модели со случайными весами показала совпадение логитов с эталоном Transformers при предзаполнении и декодировании, а расхождение эмбеддингов изображений — около 1e-5. Есть подвох совместимости: готовые кванты Unsloth используют идентификатор архитектуры glm5next вместо glm5-next, поэтому основная ветка llama.cpp может их не загрузить без правки метаданных. Комментаторы жалуются, что поддержка новых архитектур в llama.cpp отстаёт от релизов на недели и месяцы. Готовые локальные инструменты собраны в разделе Open Source на AI SKILLS.
Claude Sonnet 5.5 собрал 30-секундный ролик из кода: $35,40 против $50,48 на Opus 5.5
Пользователь r/ClaudeAI сделал с Claude Sonnet 5.5 видео длиной 30 секунд в 1080p и 60 кадров в секунду без видеомодели: кадры рисовал canvas в безголовом Chrome, склейку делал ffmpeg, звук синтезировался. По подсчёту автора, работа заняла около 2,4 часа, 779 вызовов инструментов, 739 тыс. выходных токенов и 101,6 млн токенов чтения из кэша. В пересчёте на цены API это $35,40 на Sonnet 5.5 против $50,48 на Opus 5.5; разница меньше двукратной, потому что чтение кэша стоит $0,20 за миллион токенов у обеих моделей. Главное возражение в обсуждении: переносить расход токенов Sonnet на цены Opus некорректно, ведь Opus мог бы потратить на ту же задачу другое число токенов и шагов. Моушн-дизайнер добавил, что такое видео трудно править покадрово, поэтому для профессионального пайплайна оно пока малопригодно.
ИИ-безопасность: Opus 5.5 и Astra переписывают больше половины текста незаметно для детектора Pangram
Vals сообщила, что Claude Opus 5.5 и GPT-6 Astra способны переписать больше 50% документа так, что детектор Pangram его не помечает. Детектор ИИ-текста — это классификатор, который оценивает вероятность того, что текст написан моделью, а не человеком. Результат бьёт и по исследованиям: оценки доли ИИ-текста в интернете часто опираются именно на такие метки. Параллельно Artificial Analysis показала, что на кибербенчмарке CyberGym-E2E-AA часть фронтирных моделей отказывается выполнять больше 85% задач из соображений безопасности. Goodfire представила мониторы биологического риска в реальном времени и заявляет устойчивость к атакам в 3–5 раз выше, чем у принятых методов скрининга, при меньшем числе отказов на задачах двойного назначения. Apollo Research опубликовала принципы для внешних оценщиков, которые получают доступ к лабораториям на правах сотрудников.
Цифры и факты
Сводная таблица AI SKILLS: локальный запуск открытых моделей, начало октября 2026 года
| Модель и сборка | Железо | Результат | Источник |
|---|---|---|---|
| Qwen3.8-27B, IQ4_XS, 14,25 ГБ | 1× RTX 4090 24 ГБ | 115 ток/с, пик 22 934 МиБ, контекст 196 608 | r/LocalLLM |
| Qwen3.8-Flash-Next, iq4_xs, MTP | DGX Spark | 28,36 → 43,88 ток/с (×1,55) | llama.cpp #29761 |
| GLM-5.3-Flash, 320B, текст и зрение | — | поддержка влита, логиты совпадают с Transformers | llama.cpp #27773 |
- +30% пропускной способности и −15% энергопотребления относительно HBM4E обещает память NVHBM, в которой контроллер перенесён в собственный базовый кристалл (@vikramskr); Micron говорит, что NVHBM улучшит её маржу, автор с этим спорит.
- 1,6 мс на чтение (p99) у Cloudflare KV Instant в закрытой бете, но хранение стоит $100 за мегабайт в месяц, чтение — $0,20 за миллион, запись — $0,10 за операцию (сводка релизов).
- До 10 000 токенов в секунду на пользователя на моделях больше 10 трлн параметров — цель стартапа Volantis, который делает ставку на оптику (@omarsar0).
- До 2,54× без потери качества ускоряют генерацию новые черновые модели DFlash для Ornith-1.5 (@ornith_).
Разные точки зрения: должна ли ИИ-лаборатория спорить с Ватиканом о сознании моделей?
По данным NYT, Крис Ола из Anthropic обсуждал отказ от участия в презентации энциклики Папы Римского об ИИ, текст которой отвергает сознание у машин; об этом сообщил Кристофер Хейл, пост собрал 28,7 тыс. реакций. Команда Олы, по сообщениям, добивалась от советников Папы серьёзного отношения к вопросу сознания моделей, и в итоге он на презентацию пришёл.
За. Позиция Олы, с которой открывается статья, — честное признание неопределённости: «мы не знаем, обладают ли ИИ-модели сознанием». Раз ответа нет, исключать вопрос из официального документа преждевременно.
Нейтрально. Лукас Байер обратил внимание на правку формулировки в стенограмме: слово «создавать» заменено на «обучать» — то есть даже формулировки вокруг энциклики остаются предметом правок.
Против. Эйдан Гомес назвал эту кампанию моральным высокомерием. Сама энциклика стоит на той же стороне: её текст отвергает сознание у машин.
Инструменты и приёмы
- Облёт объекта на 360° в видео. LoRA MiniMax-H3-360-Orbit делает облёт по первому и последнему кадру; приём из обсуждения в r/StableDiffusion — прямо запретить в промпте любое движение объекта, чтобы двигалась только камера. Сформулировать такой промпт поможет генератор промптов AI SKILLS.
- Поиск виноватого коммита. Cursor Rollouts при регрессии находит pull request, который её вызвал, открывает задачу и предлагает исправление облачным агентом в один клик.
- Песочницы для агентов. Cloudflare Sandbox SDK 1.0 даёт Durable Objects прямое управление контейнерами-песочницами — удобная основа для агентских сценариев; готовые сценарии автоматизаций есть в шаблонах AI SKILLS.
Коротко
- Агенты без поиска набирают лишь 2,9% в юридических и 7,4% в финансовых задачах нового Vals Web Search Index против 30–50% с поиском (детали).
- AgentWorld: меньше трети действий в многоагентных системах помогают решить задачу, а задачи на координацию решаются лишь в 12% случаев (@omarsar0).
- ProVer даёт относительный прирост +9,91% на Qwen3.5-2B и +7,12% на Qwen3.5-4B к GRPO за счёт точной оценки вклада шагов (@omarsar0).
- ScholarCatalyst — бенчмарк исследовательского чутья: 184 ведущих автора разметили 207 своих проектов (@yoonholeee).
- ИИ как компилятор: модель переводит Triton прямо в PTX с верификатором и ускоряет FlashAttention на B200 до 1,37× (@Azaliamirh).
- Epoch AI оценивает, что ИИ-инфраструктура скоро сможет обслуживать от сотен миллионов до миллиардов агентов (@EpochAIResearch).
- Йошуа Бенджио вошёл в новый Национальный совет Канады по ИИ (@Yoshua_Bengio).
- Google Research запустила федеративное обучение на доверенных средах исполнения (TEE) с проверяемой дифференциальной приватностью (@GoogleResearch).
- The AI Daily Brief 5 октября 2026 года разобрал, почему компании хотят ИИ, которым владеют сами, и как этот спрос может вернуть американские открытые веса — выпуск «Why Companies Want AI They Can Own».