Reflection Beam: 501B под Apache 2.0 — AI-дайджест
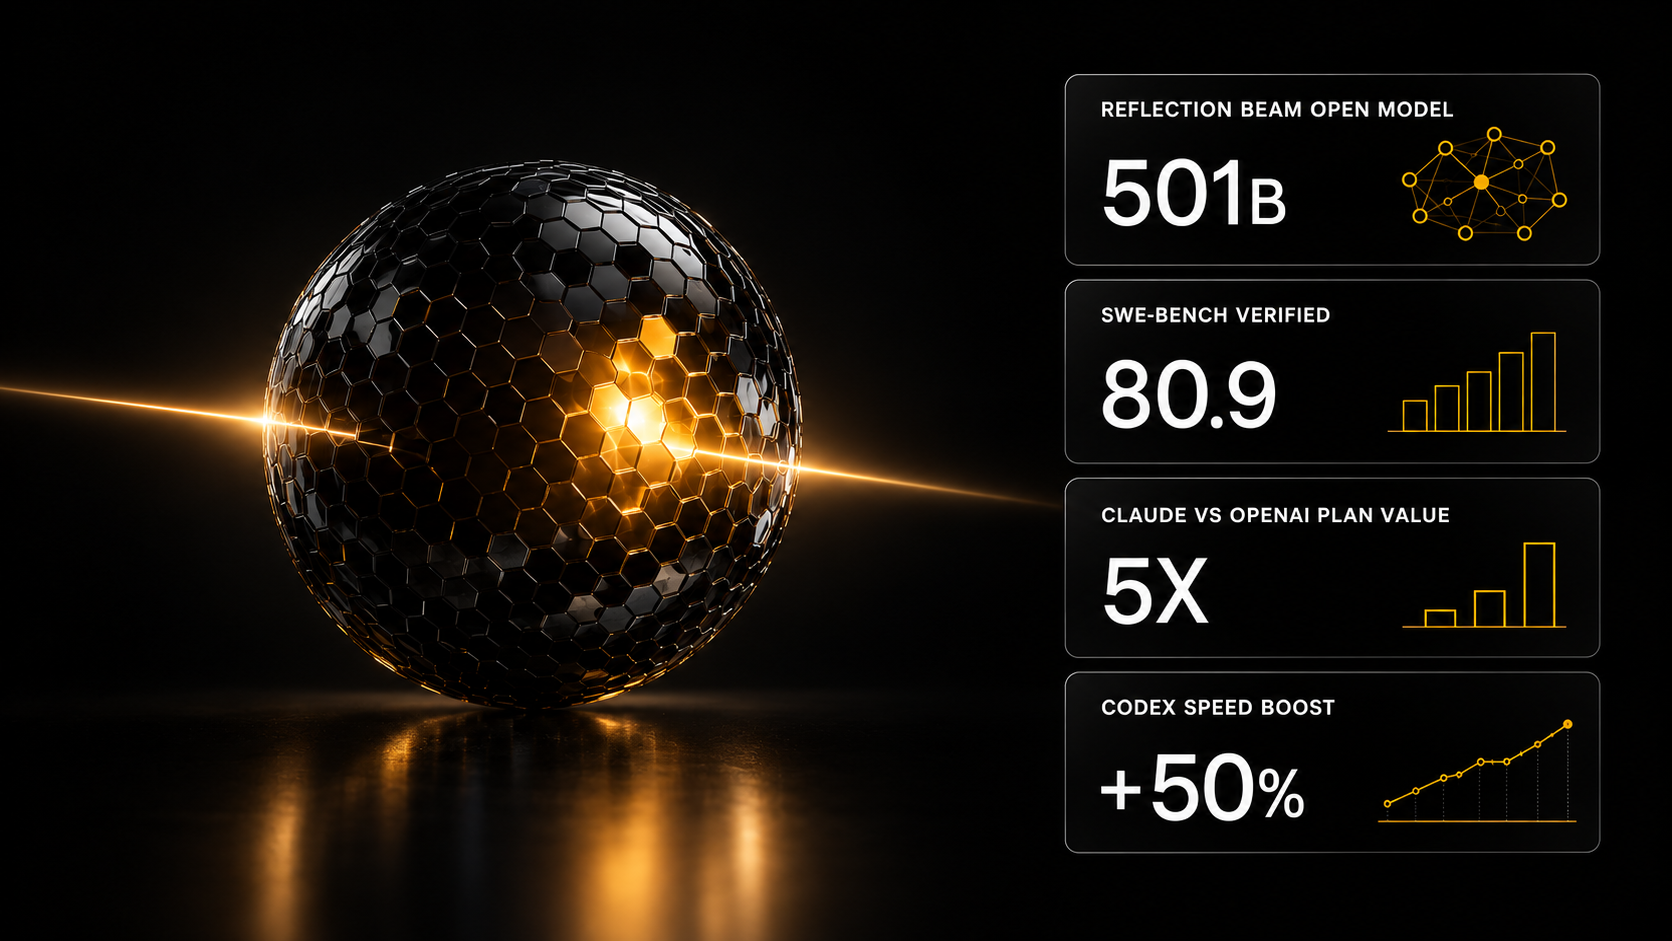
Reflection AI выпустила Beam на 501 млрд параметров с весами под Apache 2.0, SemiAnalysis насчитала у подписок Claude в 5 с лишним раз больше ценности, чем у OpenAI, а OpenAI вводит водяные знаки в тексты ChatGPT для ЕС.
Главное сегодня
Reflection Beam: 501 млрд параметров, 80,9 на SWE-bench Verified и веса под Apache 2.0
Reflection AI представила Beam — текстовую модель на 501 млрд параметров, из которых на каждый токен работают 23 млрд, для кода, агентных и научных задач; полные веса под лицензией Apache 2.0 обещаны в октябре 2026 года. Об этом говорят анонс компании и пост Миши Ласкина. Смесь экспертов (MoE) — это архитектура, в которой на каждый токен включается лишь часть весов, поэтому 501 млрд параметров по вычислениям обходятся как 23 млрд. Beam обучена с нуля на 23,8 трлн токенов, часть из которых получена распознаванием сотен миллионов PDF, — по словам руководителя данных. Обучение с подкреплением шло на 10 тыс. ускорителей GB300: больше 100 млн прогонов примерно на 1 млн задач. Технический отчёт и интеграции с открытыми инструментами обещаны отдельно. Как запускать открытые веса у себя — в нашем гиде по open-source LLM.
Reflection Beam в цифрах: заявки компании и цена вычислений
Сводка заявлений Reflection даёт Beam 80,9 балла на SWE-bench Verified и эффективность инференса в 3–4 раза выше, чем у GLM 5.2, при четырёх неделях предобучения и четырёх неделях обучения с подкреплением на ~10 500 GB300 (сводка). Все эти цифры — данные самой компании, независимых замеров пока нет. Axios заранее сообщил о запуске и о затратах: Reflection платит $150 млн в месяц за вычисления на Colossus и заключила сделку с Nebius на $1 млрд; по тем же данным, другие американские лаборатории тоже выпустят открытые модели в октябре 2026 года (Эндрю Карран). The AI Daily Brief 6 октября 2026 года поставил выход Beam первой новостью выпуска (эпизод). Готовые открытые инструменты собраны в разделе Open Source на AI SKILLS.
Подписки на ИИ: Claude даёт в 5+ раз больше ценности, чем планы OpenAI, — замер SemiAnalysis
SemiAnalysis сравнила подписки Anthropic, OpenAI, Meta, SpaceXAI, MiniMax, Moonshot, Cursor, Cognition и других и пришла к выводу, что тарифы Claude дают в 5 с лишним раз больше ценности в пересчёте на цены API, чем планы OpenAI. Ценность в методике SemiAnalysis считается по стоимости кредитов для каждой модели и типа токенов, а не по прайсу API. С поправкой на стоимость одной задачи преимущество Claude сжимается до 1,3–2,9 раза. Непроверенная оценка одного аналитика: Anthropic тратит 42% вычислений инференса на подписки, которые приносят ~10% выручки. Параллельно The Information сообщает, что Microsoft урезала плановые внутренние расходы на Anthropic больше чем на треть, а число пользователей Claude Code в Meta упало примерно с 60 тыс. до 30 тыс. — в основном из-за перехода на собственные инструменты Meta (сводка).
Codex: OpenAI обещает улучшение каждый день 28 дней и ускорила GPT-6 Astra на ~50%
Руководитель Codex Тибо пообещал заметное улучшение или полный сброс лимитов каждый день в течение 28 дней — пост собрал 30,9 тыс. реакций. Повод — жалобы пользователей: по их сообщениям, новые подписки за $200 были приостановлены, а лимиты на всех тарифах фактически урезаны вдвое; GPT-6.1 Sol подавалась как экономичная альтернатива. Первым днём стало ускорение: скорость GPT-6 Astra и GPT-6.1 Sol по умолчанию выросла примерно на 50%, с ~30 до ~50 токенов в секунду, на всех подписках и у партнёров входа через ChatGPT — OpenCode, Pi, Amp и Devin. Шероховатости остаются: накопленные сбросы Codex сгорают без учёта часового пояса, а постоянно работающий агент Dots доступен только на тарифах Pro от $100.
ИИ-безопасность: OpenAI вводит водяные знаки в тексты ChatGPT и Codex в ЕС
OpenAI добавит невидимые статистические водяные знаки в подходящие тексты ChatGPT и Codex для пользователей ЕС по требованиям AI Act, а в API по всему миру появится переключатель для включения по желанию. Водяной знак в тексте — это незаметный статистический узор в выборе слов модели, по которому специальный детектор потом узнаёт сгенерированный текст. Ограничения компания называет сама: пересказ или перевод знак стирают, а детектор получат только одобренные исследователи. Критики приводят тест, в котором замена 25% слов синонимами снижает обнаружение примерно с 92% до 17%. На фоне громких инцидентов с агентами Йошуа Бенджио в колонке для FT доказывает, что недавние взломы агентами — не просто проблема песочниц, а Нил Нанда назвал инцидент OpenAI и Hugging Face самым заметным провалом выравнивания на сегодня.
Hugging Face: 10 агентских харнесов стали средами обучения с подкреплением
Hugging Face превратила 10 немодифицированных агентских харнесов в среды обучения с подкреплением через прокси, который понимает форматы OpenAI Chat, OpenAI Responses, Anthropic и Gemini и записывает точные идентификаторы токенов и логарифмы вероятностей для TRL. Харнес — это обвязка вокруг модели: цикл, инструменты и формат вызовов, в которых агент выполняет задачу. Эксперимент показал, насколько обвязка важна: одни и те же веса набирают 62% в Mini-SWE-Agent и 33% в Claude Code. Обучение LFM2.5-2.6B сразу на 4 харнесах подняло долю задач, решённых с первой попытки, с 42% до 54%, а бонус за вызов инструментов сократил число вызовов на 31%; обычное дообучение на 3189 прогонах упирается в 47,5%. Оговорка авторов: один тип задач и одно зерно генератора. Сами среды теперь хранятся и версионируются на Hugging Face Hub, как датасеты. Готовые агентские сценарии — в шаблонах автоматизаций AI SKILLS.
Цифры и факты
Сводная таблица AI SKILLS: открытые веса и новые модели, неделя 3–5 октября 2026 года
| Модель | Параметры | Лицензия и доступ | Заявленный результат | Источник |
|---|---|---|---|---|
| Reflection Beam | 501B всего / 23B активных, MoE, только текст | Apache 2.0, веса в октябре 2026 | 80,9 SWE-bench Verified | Reflection |
| Aleph Alpha Kolibri | 78B всего / 3,46B активных | Apache 2.0, немецкий и английский | 96,9% AIME 2025, 84,3% GPQA Diamond, 66,4% SWE-Bench Verified | сводка |
| Reka Rho-1 | 19B, омни: текст, изображения, видео, действия роботов | — | обучена с нуля на 320 H100 за ~3 месяца | Reka |
| Upstage Solar Mini 4 | 35B всего / 3B активных, контекст 512K | бесплатно на Nous Portal две недели | — | Nous |
| Command Code Agr / Agr-flash | 31B / 360M, без генерации текста | — | возвращают типизированные значения с вероятностями для вызовов инструментов и маршрутизации | Command Code |
Все результаты в таблице — данные разработчиков. У Kolibri датасет не раскрыт, а агентные оценки заметно ниже, чем у Qwen.
- $0,24 против $13,41 за задачу при одинаковом балле DeepSWE заявляет маршрутизатор Cline Pareto 26.10 Preview (Cline).
- $0,08 за миллион входных и $5,00 за миллион выходных токенов — такую цену GLM 5.3 нашёл Хорас Хе у inference.net и объяснил её перекосом маршрутизации цен OpenRouter (тред, механика).
- До 3,4 раза быстрее обычного декодирования работает спекулятивное декодирование в llama.cpp на Metal: 110 против 32,1 токена в секунду на M3 Ultra (qvac); версия llama.cpp v0.6.0 добавила Qwen3.8-Flash-Next и новый API
llama_batch_ext(Георгий Герганов). - ~$600 в день тратил на кодинг-агентов медианный исследователь OpenAI к середине августа 2026 года в пересчёте на цены API; эти расходы удваивались примерно каждый месяц (Epoch AI).
- На 90% быстрее декодирование и на 57% меньше время до первого токена у движка Baseten, собранного за неделю почти автономной работы агентов (блог).
- 216 ГБ памяти и 1200 ГБ/с межсоединения у ускорителя Alibaba T-Head Zhenwu V900; поставки — в первом квартале 2027 года (SemiAnalysis).
Разные точки зрения: Reflection Beam — прорыв американских открытых весов или повтор DeepSeek V3?
Reflection Beam — это 501 млрд параметров, 23 млрд активных, 80,9 на SWE-bench Verified по собственным данным и веса под Apache 2.0. Американских открытых моделей такого размера мало, поэтому спор идёт не о факте выпуска, а о том, догоняет ли Beam китайских лидеров.
За. Artificial Analysis, получившая ранний доступ, ожидает, что Beam окажется среди самых экономных по токенам открытых моделей для своего уровня интеллекта. Эли Бакуш отмечает, что на отложенном коде у Beam перплексия лучше, чем у DeepSeek V4.
Нейтрально. Натан Ламберт ставит Beam в один ряд с моделями Nvidia и Thinking Machines как сильные американские релизы, которые всё же отстают от китайских. Наблюдатели помещают Beam примерно на уровень GLM-5.2.
Против. Teortaxes называет Beam повторением DeepSeek V3 при том же бюджете вычислений и оценивает около 1,3 млрд RL-песочниц за 4 недели. На части бенчмарков Beam уступает DeepSeek V4 Flash, а Бакуш оценивает загрузку ускорителей при предобучении всего в ~12%. Ещё до анонса в r/LocalLLaMA напоминали историю Reflection 70B и сомневались, что компания вообще выпустит веса.
Инструменты и приёмы
- Моды для Claude Code. Мод — это небольшое дополнение, которое меняет поведение или вид Claude Code: блокирует рискованные команды, скрывает секреты в выводе, добавляет свои кнопки и панели; ставится как плагин, а собрать его может сам Claude (Ben's Bites). Как устроены расширения Claude Code — в нашем гиде по скиллам Claude Code.
- Управление агентом на ходу в Cursor SDK. Обновление добавило вмешательство в середине прогона, фоновых субагентов с отчётом родителю и заменяемые системные промпты, а также пометки MCP
readOnlyHintиdestructiveHintдля собственных инструментов. - Долгоживущие агенты на Pi Durable. Харнес Earendil построен на небольшом движке задач, поэтому долгий многопользовательский агент может приостановиться и продолжить работу с любого места; ядро — около 15 тыс. строк TypeScript с хранением в SQLite или JSONL, работает на Bun или Cloudflare Durable Objects (разбор).
Коротко
- The AI Daily Brief: почти 98% домохозяйств США не платят ни за одну подписку на ИИ — выпуск 6 октября 2026 года разбирает, рынок это или тупик (эпизод).
- Agent Arena: Anthropic на первом месте в категориях Code, Work и Chat, Fable 5.1 лидирует в Code и Work, GPT-6 Astra — второй в Code (Arena).
- Галлюцинации: на AA-Omniscience Gemini 4 Argon ошибается в 15% вопросов, ответа на которые не знает, против 29% у следующей модели; у GPT-6 Astra самая высокая точность — 61% (данные).
- Eleven v4 Turbo возглавил арену синтеза речи Artificial Analysis при цене вдвое ниже v4 (AA).
- Vals AI: больше 90 агентов на Opus 5.5 за 3 дня расчётов DFT нашли двух кандидатов в магнитные полупроводники при комнатной температуре; это только прогнозы (тред, оговорки).
- Верификатор вместо выборки: проверка 8 кандидатных команд верификатором на GPT-5.6 Sol поднимает Pass@1 на TerminalBench-Lite с 50% до 68% (сводка).
- SelfSearch заявляет 82,0% на Terminal-Bench 2.1 с DeepSeek V4 Flash — на уровне Codex — при $4,03 на поиск (статья).
- Сжатие контекста: в ~35 тыс. запусков сжатие до трети токенов оказывалось на 20–80% медленнее полного контекста (сводка).
- Google Docs начнёт открывать файлы Markdown без конвертации — включение займёт две недели, так AGENTS.md можно править и комментировать командой (Ben's Bites).
- Опрос Quinnipiac: 86% опрошенных поддерживают независимые стандарты безопасности ИИ (Йошуа Бенджио).
- Чипы и Китай: Tencent, по данным FT, арендовала ~100 тыс. передовых чипов в дата-центрах Oracle в Юго-Восточной Азии примерно за $7 млрд на пять лет (сводка); в США реселлеру из Калифорнии предъявлено обвинение в контрабанде GPU-серверов в Китай на сумму больше $300 млн (сообщение).
- AMD, по сообщениям, купила World Labs за $8,2 млрд (DL Weekly).